

做内容审核、意图分类、情感判断这类活,很多人现在的第一反应是:调个大模型,让它输出"是"或"否"。
跑通是能跑通,但用起来总有点别扭。
一是慢,二是贵,三是输出不稳定——同一个问题问两次,措辞不一样,结论可能就飘了。你想要的其实只是一个分数、一个类别,模型却给你回了一段话,还得自己解析。
最近翻到一个叫 Laya 的开源项目,思路正好相反:它不生成文本,只做判断。
01 它解决的是什么问题
现在大部分 AI 应用默认把所有任务都交给生成式大模型,包括那些本来很"轻"的任务:这条评论是不是广告、这句话属于哪个意图、这段内容和用户问题相关不相关、这个回答该打几分。
这些任务的共同点是——你要的不是文字,是一个决策。
生成模型做这类事,本质上是"用大炮打蚊子":一个字一个字往外蹦,跑到最后才给你一个结论。Laya 的做法是把这个过程砍掉,一次前向传播直接输出结构化结果。
从项目文档看,官方给的延迟数字是 33 毫秒。
02 它到底是什么
一句话:一个多语言、非自回归的决策引擎。
"非自回归"是关键——它不像 GPT 那样逐 token 生成,而是一次前向就出结果。这也是它能做到毫秒级的原因。
它支持三类决策:
- Choice:从给定选项里选一个
- Score:对一段文本打分
- Yes/No:二选一判断
覆盖 100 多种语言,并且带一个 router,会按请求自动选择最合适的 checkpoint,不用你自己判断该加载哪个模型。
训练方式上,项目提到用强化学习对着 strictly proper scoring rules 做优化——翻译成人话就是:它输出的分数是可校准的,0.8 就该比 0.6 更可信,而不是随口给个数字。
这一点我比较关注。分类模型好不好用,很多时候不取决于准不准,而取决于它的置信度能不能被下游系统信任。
03 怎么跑起来
项目已经发布到 PyPI,安装就是一行:
pip install laya
这条命令安装的是 Laya 的 Python 包,前置环境是 Python + PyTorch。
具体的调用方式,官方提供了 Colab Notebook 和在线文档,建议先跑一遍 Notebook 再动手改。项目也有 Hugging Face Space 可以直接在线试,不想装环境的话可以先在网页上看看效果。
04 几个真实用得上的场景
场景一:内容审核前置过滤
先用 Laya 做一遍快速判断,把明显没问题的内容直接放行,只把边界样本交给大模型复核。这样能省掉大量不必要的模型调用。
场景二:意图路由
用户提问进来,先判断属于哪一类意图,再决定分发给哪个 Agent 或哪套工具。这类任务不需要生成,只需要分类,用它比调大模型合适得多。
场景三:给输出打分
用它给模型回答打一个质量分,分数偏低的再走人工或重试流程。因为分数是可校准的,设阈值比用生成模型"感觉一下"靠谱。
05 使用前要注意的几点
说实话,这个项目不是那种"clone 下来就能上生产"的类型。
第一,它是专用模型,不是通用模型。你没法让它写文案、做摘要、回答问题。它只做判断,别指望它干别的。
第二,33ms 是官方给的数字,实际延迟取决于你的硬件、模型大小和并发情况,别直接拿来做容量规划。
第三,多语言支持的实际效果,不同语种之间大概率有差距,中文场景建议先用自己的数据小样本验证一遍再决定。
第四,它依赖 PyTorch 环境,如果你的服务是纯 CPU、低内存的轻量部署,需要先评估模型体积。
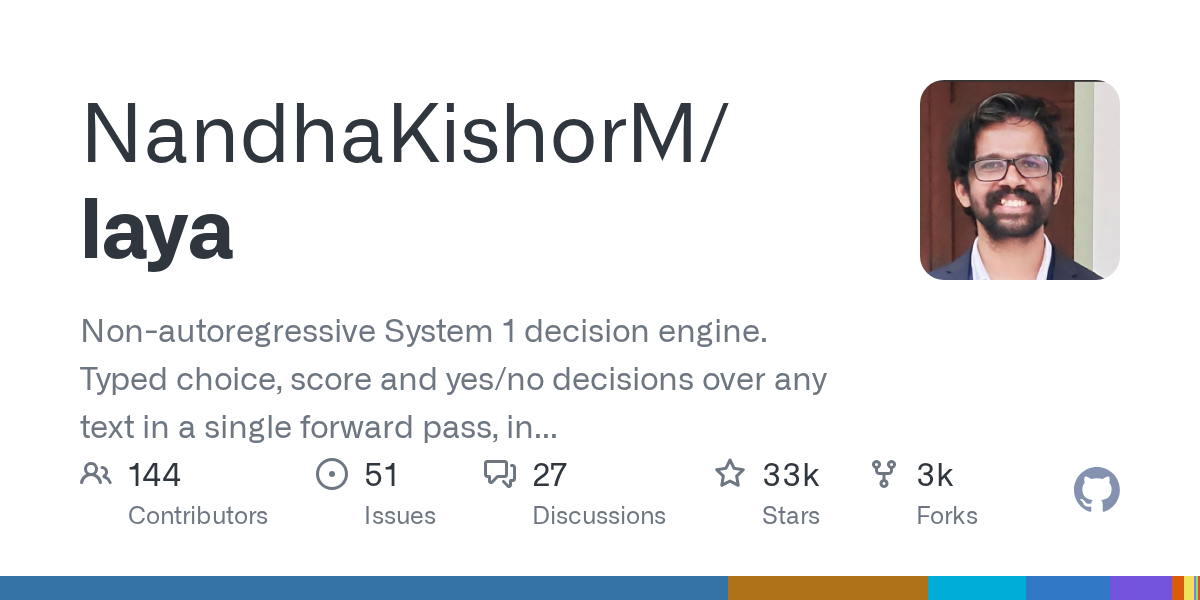
第五,截至文章整理时项目约 3.2 万 Star,热度不低,但仍建议关注版本变动,接口和 checkpoint 有可能调整。
06 适合谁,不适合谁
适合:
- 手里有一堆分类、审核、打分任务,正在为大模型调用成本发愁的开发者
- 想做意图路由、需要低延迟判断的 Agent 项目
- 对模型置信度校准有要求的团队
- 想研究非自回归架构和多语言决策模型的人
不太适合:
- 需要生成能力的场景
- 想找一个开箱即用的成品工具的人
- 对稳定性要求极高、不愿意跟进版本变化的生产项目
07 如果是我,会重点看这三处
- router 怎么选 checkpoint:这套机制如果设计得好,可以直接复用到自己的多模型调度上
- 分数校准是怎么做的:strictly proper scoring rules 配合强化学习训练,这个思路比结果本身更值得研究
- 非自回归在分类任务上的取舍:牺牲了什么换来了速度,边界在哪
值不值得试
如果你的任务本质是"判断"而不是"生成",那这个项目值得花半小时看看文档。它未必能直接替换你现在的方案,但它提醒了一件事:不是所有 AI 任务都该交给生成式大模型。
如果你只是想找个能聊天的 AI,那这个项目和你关系不大。
项目地址:https://github.com/NandhaKishorM/laya
项目信息
- 项目:Laya(NandhaKishorM/laya)
- GitHub:https://github.com/NandhaKishorM/laya
- 技术栈:Python、PyTorch
- 安装方式:pip install laya
- 项目状态:开源,提供文档、Colab 与在线 Demo
- 适合人群:做分类、审核、路由、打分类任务的开发者
你最近在做的项目里,有没有那种"其实只需要一个判断"却一直用大模型硬扛的任务?可以留言说说,我后面继续整理这类轻量方案。
额外输出:适合做封面的短标题
- 判断任务不用大模型
- 33ms 完成一次判断
- 专做决策的 AI 引擎
额外输出:摘要
分类、审核、路由这类任务,其实不需要生成式大模型。这个开源项目用单次前向传播直接给出判断结果,延迟 33ms。
额外输出:推荐标签
#开源项目 #GitHub #AI工具 #Python #模型部署 #程序员 #NLP
本期项目
评论区