

正文:
一个很常见的浪费
去年我做过一个工单分流的小功能:把用户提交的问题分成「退款」「账号」「技术故障」几类,再判断要不要转人工。
最开始图省事,直接调大模型,prompt 里塞 JSON Schema,让它输出结构化的分类结果。上线后问题来了:一次请求 1 秒多,高峰期排队;偶尔返回带解释的废话,解析失败还得重试;最麻烦的是那个「置信度」根本不敢用,0.8 和 0.6 在我看来没区别。
后来换成训练一个小分类模型,延迟下来了,但每个新任务都要重新标数据、训模型,运营改一次分类体系我就得加班一次。
这类「封闭式判断」的需求其实特别多:这条评论要不要拦、这句话是不是投诉、这个工单紧急程度打几分。它不需要模型会写文章,只需要它在有限选项里选一个,而且最好快、便宜、分数可信。
Laya 就是冲这个场景来的。
它是干什么的
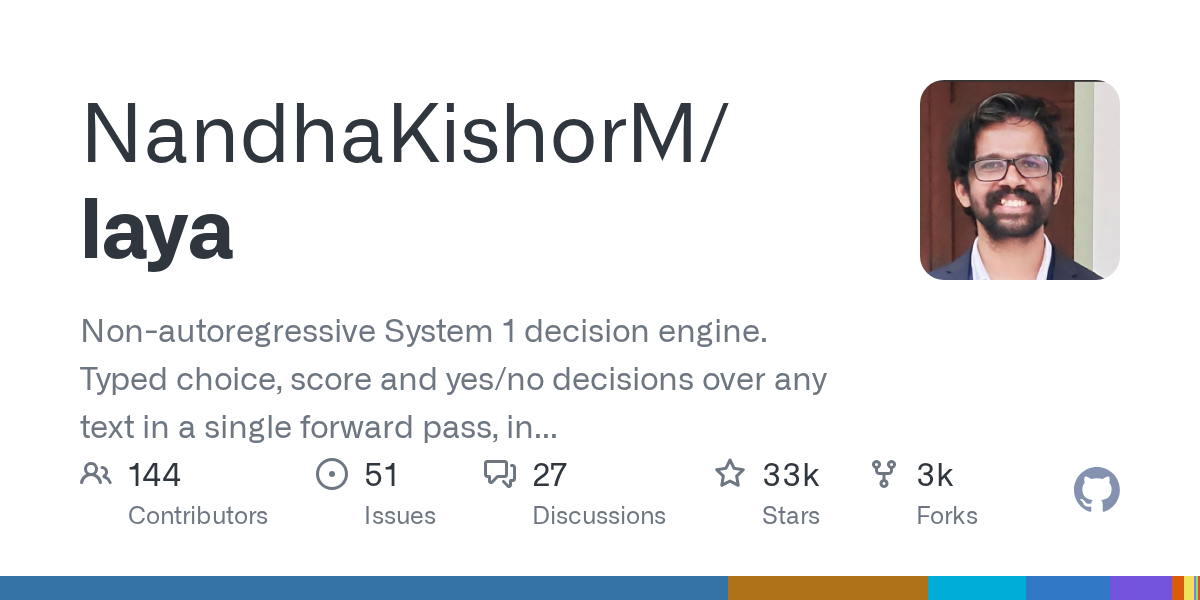
一句话:Laya 是一个非自回归的「System 1 决策引擎」,在一次前向传播里对任意文本给出类型化的决策结果——多选一、打分、是/否,覆盖 100 多种语言。
两个关键词值得展开。
非自回归:它不像 GPT 那样一个 token 一个 token 往外蹦。生成式模型的延迟和成本,很大一部分花在「把答案写成一段话」上。Laya 跳过了这一步,直接输出决策。README 里给的数据是单次前向 33ms。
System 1:借用的是「快思考」这个概念,对应的是需要多步推理的慢思考。它不负责推导,只负责判断。
项目地址是 github.com/NandhaKishorM/laya,截至整理时 Star 在 3 万左右。技术栈是 Python + PyTorch,底座跟 ModernBERT 一路,权重放在 Hugging Face 上,也有 PyPI 包和 Colab 可以直接跑。
三个我认为有价值的设计
一、三种决策类型是原生的
不是让模型输出 "yes" 这个字符串再自己解析,而是模型结构上就分了三类头:从 N 个选项里选一个、给一个分数、给一个是/否。这意味着输出格式的稳定性由模型保证,你不需要写一堆正则去兜底。
对做工程的人来说,这比多两个点的准确率更值钱——解析失败的重试逻辑、异常兜底、脏数据清洗,这些代码量加起来往往比调模型本身还多。
二、分数是校准过的
它用强化学习针对「严格 proper scoring rule」训练(README 里叫 RLCD)。说人话就是:模型说 0.9,那这一类样本里大概真有九成是对的。
这点在实际业务里比准确率更关键。因为大部分场景你要的不是「答案」,而是「阈值」——比如分数低于 0.7 的全部转人工。分数不可校准的模型,这个阈值只能靠拍脑袋定,然后每隔两周被业务方追着问为什么误杀。
三、多语言靠 router 分流
100+ 语言不是靠一个巨型模型硬扛,而是每次请求由一个 router 挑合适的 checkpoint。好处是不同语种不至于被大语种的语料稀释;代价是你得接受它在运行时做一次路由决策,模型体积和显存占用也要按「可能加载多个」来算。多语言场景下这点要提前评估。
怎么跑起来
安装本身没有门槛:
pip install laya
具体的推理调用方式,建议直接对照官方文档和那个 Colab Notebook 来——这个项目还在快速迭代,我不太建议照抄博客里的 API 片段,容易对不上版本。Hugging Face 上也有现成的 demo Space,想先看效果可以不下环境直接试。
一个我脑内的典型用法:把客服对话的最后三条消息拼起来喂进去,选项设为「咨询 / 投诉 / 退款 / 其他」,拿到分类结果和分数,分数低于阈值的那部分直接进人工队列。整条链路不需要拼 prompt,也不需要处理模型返回的客套话。
动手前要确认的几件事
33ms 这个数字要看测试条件。 README 没写明是什么硬件、什么 batch size、多长文本下的结果。单条推理和批量吞吐是两回事,如果你的场景是离线跑几百万条,压测时请按吞吐量算,别按单条延迟乘。
它不能生成任何东西。 这是最容易被误解的一点。想要「先分类再生成回复」的完整链路,Laya 只能承担前半段,后半段还是得接生成模型。
选项是封闭的。 你给的候选之外没有「以上都不是」的自动兜底,类别体系设计不好,模型也会硬选一个。类别设计这件事,还是得人来。
项目年轻。 Star 涨得快不等于 API 稳定,早期项目改接口、改权重命名都很正常。要上生产的话,锁死版本号,别用 latest。
多语言效果不均。 100+ 语言是覆盖范围,不是每个语种都同等水平。中文场景建议先拿自己的真实数据跑一批,别直接采信总榜。
适合谁,不适合谁
适合:要做意图分类、内容审核、情绪/紧急度打分、是/否判断这类封闭式决策;对延迟和成本敏感;多语言业务;已经有少量标注数据但不想每个任务训一个模型。
不适合:需要生成文本、需要多步推理、需要开放式问答的场景;类别体系还没定下来、天天改需求的场景;以及只想调个 API 不想碰模型部署的人——它需要你自己跑推理服务。
项目卡片
| 项 | 内容 | | --- | --- | | 项目 | Laya | | GitHub | NandhaKishorM/laya | | 技术栈 | Python、PyTorch、ModernBERT、Hugging Face | | 安装 | pip install laya | | 状态 | 早期活跃迭代中 | | 适合人群 | 需要低成本、低延迟封闭式决策的开发者 |
我的判断
生成式模型这两年吃掉了很多本来不属于它的活。分类、打分、是否判断这类任务,本质上不需要「会说话」,需要的是快、稳、分数可信。
Laya 的价值不在于它多聪明,而在于它把这类任务从「写 prompt 猜输出格式」拉回到「一个正经的判别模型」上。如果你的项目里还有大量用 LLM 做简单判断的接口,值得花半天评估一下换掉能省多少。
你手上现在有没有那种「用大模型做分类,明知道浪费但一直没换」的接口?换的成本卡在哪一步,欢迎留言聊聊。
本期项目
评论区