

一个被问过很多次的问题
我做过几个带内容分流的后端。最常见需求长这样:这条评论要不要进人工审核?这条用户消息属于哪个工单分类?这个搜索词该走哪条召回通道?
答案本身只有几个字节——是、否,或者 A/B/C。但我们得先拼 prompt,调一次大模型,等几百毫秒到几秒,再写正则从返回文本里抠 JSON,抠失败就重试。
延迟和成本全花在“生成”上,而我们要的只是“判断”。
Laya 就是冲这个缝隙来的:把“做判断”从生成式模型里单独拆出来,做成一个一次前向就出结果的决策引擎。
它到底是什么
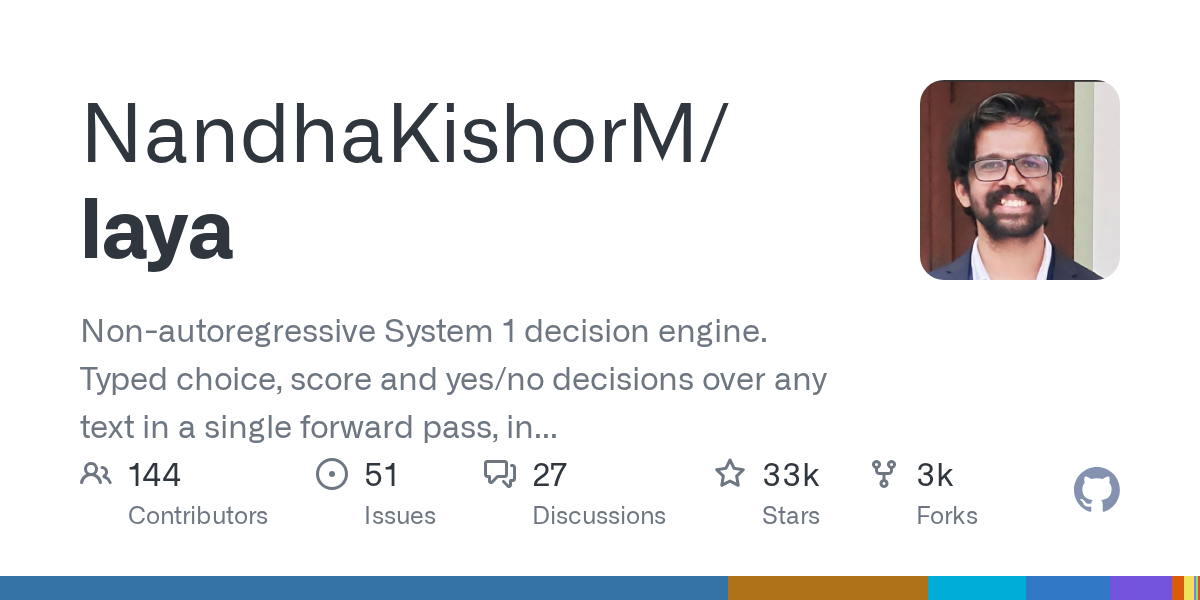
一句话:非自回归的 System 1 决策引擎,对任意文本做类型化决策。
两个词简单解释。非自回归指不逐 token 生成,一次前向直接把决策算出来——所以它不会“说话”,只给结果。System 1 借的是快思考/慢思考那个比喻,它做的是直觉式判断,不是多步推理。
决策形态有三种:typed choice(从你给的选项里挑一个)、score(打分)、yes/no(二值)。
输入支持 100+ 语言,官方给的延迟数字是 33ms。入口前面挂了个 router,按请求内容挑对应的 checkpoint,你不用自己维护“语种→模型”的映射表。
训练方式值得注意:用强化学习对着严格适当评分规则(strictly proper scoring rules)优化,仓库标签里标了 calibration。这条对工程最有用——它意味着输出 0.8 就大致对应 80% 的置信度,你能直接拿来设阈值。
三个我觉得值得看的地方
延迟结构变了。 33ms 和几百毫秒不是“快一点”的关系。一条链路里要判好几次(先判合规、再判意图、再判要不要转人工),延迟是叠加的。判断降到几十毫秒级,你才敢把它塞进同步链路。
输出是类型化的,不是一段话。 做过 prompt 的人都懂,“只输出 YES 或 NO”这句话有一半时间不生效。类型化决策省掉的是解析、重试,以及半夜被告警叫起来看 bad case 的那部分工作量。
可校准的分数能用来分级。 打分不只为了排序。分数可校准,你才敢写“大于 0.9 自动通过,0.6~0.9 转人工,低于 0.6 拦截”这种规则,而不是拍一个阈值然后天天调。
装起来看一眼
pip install laya
包已发布到 PyPI,装完可直接用。官方也放了 Colab,不想配环境就先在浏览器里跑 demo 看输出形态。HuggingFace 上的模型 id 是 convaiinnovations/laya,多语言版本是 laya-multilingual。
具体调用 API 我不在这里贴。这份 README 的示例是截断的,我不想凭印象写一段跑不通的代码误导人,以官方文档和 Colab 里的写法为准。
上手前需要知道的
它不做生成。 需要解释理由、需要输出审核意见文案的,别指望它。它只给判断结果。
33ms 有前提。 大概率是单条短文本、GPU、批量为 1 的条件。你在 CPU 上跑、文本几千字、或者自己加了前后处理,数字都会变。上线前自己压测,别把 README 的数字当 SLA。
router 意味着多份权重。 按请求选 checkpoint 很方便,代价是部署体积和显存。如果你们请求的语种很集中(比如只有中英),router 的价值就没那么大,甚至可以只挂一个 checkpoint。
校准好 ≠ 你的领域准。 通用校准和你们公司工单分类的准确率是两件事。垂直领域一定要用自己的标注集验一遍混淆矩阵,类别不均衡时尤其要看。
项目还在早期。 有 PyPI、有 HF 模型、有 Colab、有文档,配套算齐的,但这种阶段的 API 和默认行为都可能在版本间变化。生产接入先灰度,把模型版本钉死。
Star 数别当依据。 截至整理时仓库显示 3 万+,两次抓取的数字还有小幅波动。这个量级对一个新项目来说偏高,我只能说数字是动态的,选型还是看它解不解决你的问题。
适合谁,不适合谁
适合:需要海量、低延迟、二值或多选判断的后端服务;多语言内容审核的前置层;给 Agent 做便宜的路由——先花 33ms 判断“这个请求值不值得调大模型”。
不适合:需要给出理由和解释的场景;需要多步推理的场景;以及数据量很小的离线任务——一个月跑一次几千条,直接调大模型写个脚本,比部署一套东西省事。
我会重点看什么
从文档和设计来看,我下一步会验三件事:33ms 在什么硬件和输入长度下成立;校准曲线在真实分布上还成不成立;router 的选择逻辑能不能被覆盖,也就是我能不能强制指定某个 checkpoint。
另外,这份素材里没给 License,商用之前自己去仓库确认一遍。
| 项 | 内容 | | --- | --- | | 项目 | Laya | | GitHub | NandhaKishorM/laya | | 技术栈 | Python / PyTorch / HuggingFace / ModernBERT | | 运行环境 | Python,模型权重托管在 HuggingFace | | 状态 | 早期项目,有 PyPI 包、文档、Colab demo | | 适合人群 | 做分类、路由、审核前置的后端与算法同学 |
最后
一个感觉越来越明显:很多团队缺的不是大模型,是一个“判断层”。真正需要生成的请求可能只占两成,剩下八成都在问是非题。
你项目里那些“其实只要一个是/否”的地方,现在是怎么处理的?还在拼 prompt 吗。评论区说说你的场景,我挑几个典型的写写怎么拆。
本期项目
评论区